Comment fonctionne la prévision de la demande par IA pour les produits sans historique de ventes ?
Les méthodes de similarité par attributs associent les nouveaux styles aux données historiques par couleur, silhouette et tissu, augmentant la précision des prévisions de 20 à 40 pour cent en 2026.
L'ESSENTIEL Résumé de la rédaction
- Les systèmes d'IA décomposent désormais les nouveaux produits en attributs tels que la couleur, la silhouette et le tissu, puis les associent aux modèles de ventes historiques d'articles similaires.
- Les détaillants signalent des améliorations de la précision des prévisions de 20 à 40 pour cent pour les produits sans historique de ventes par rapport à l'intuition traditionnelle des acheteurs.
- La prévision en démarrage à froid réduit les surstocks et les démarques tout en améliorant la disponibilité des styles véritablement nouveaux.
- Le balisage des attributs exige de la discipline : des données produits incomplètes ou incohérentes compromettent les performances du modèle et peuvent amplifier les biais.
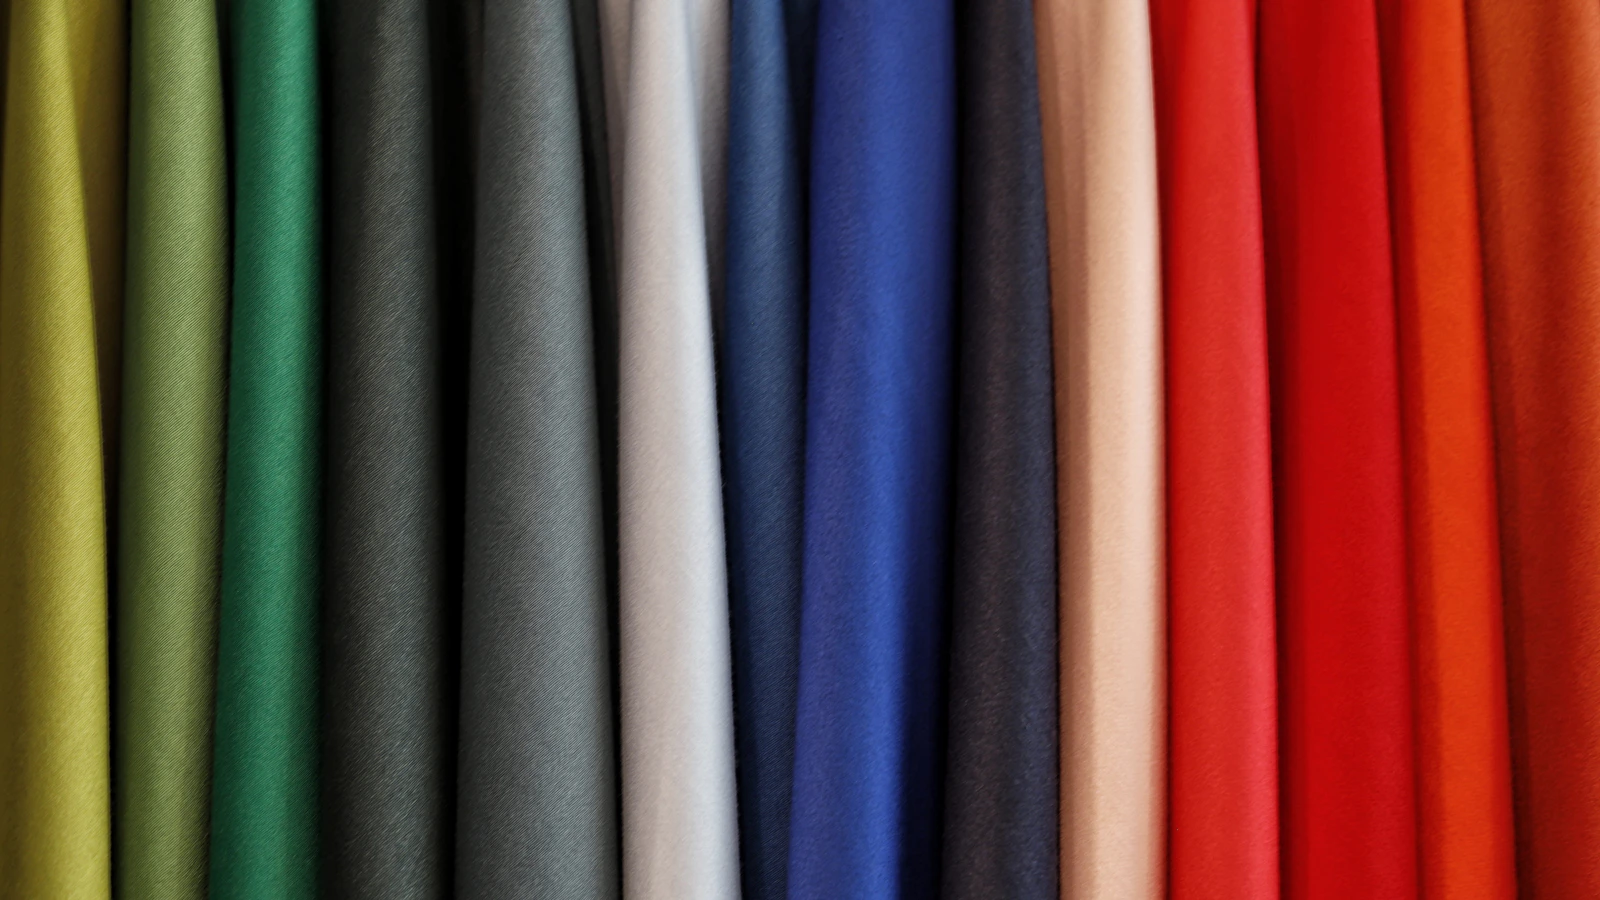
Chaque saison de mode apporte des centaines de nouveaux styles qui n'ont jamais été vendus auparavant. Les acheteurs et les merchandisers doivent s'engager sur des volumes de production et allouer les stocks des mois à l'avance, sans disposer d'historique de ventes pour les guider. Pendant des décennies, ce problème de démarrage à froid a été résolu par l'intuition humaine, les ventes comparables de la saison dernière et des règles empiriques. En 2026, les méthodes de similarité par attributs offrent une alternative basée sur les données : des systèmes d'intelligence artificielle qui décomposent chaque nouveau produit en caractéristiques mesurables telles que la couleur, la silhouette, le poids du tissu et les détails de finition, puis associent ces attributs aux performances de vente d'articles historiques partageant les mêmes caractéristiques.
La technique n'est pas nouvelle en principe. Les détaillants ont longtemps cherché des analogues lors de la prévision de la demande pour un nouveau chemisier à imprimé léopard ou un trench-coat oversize. Ce qui a changé, c'est l'échelle et la précision. Les modèles d'apprentissage automatique peuvent désormais traiter des dizaines de milliers de styles passés, identifier des modèles sur des dizaines d'attributs simultanément et générer des prévisions de demande probabilistes en quelques minutes. Plusieurs détaillants et fournisseurs de technologies signalent des gains de précision de 20 à 40 pour cent par rapport aux méthodes de référence, se traduisant par moins de démarques, de meilleurs taux de disponibilité en stock et un fonds de roulement plus faible immobilisé dans les stocks invendus.
Ce guide explique comment fonctionne la prévision de la demande basée sur les attributs, où elle apporte le plus de valeur, quelles fondations de données sont requises et quels risques demeurent non résolus.
Qu'est-ce que le problème de démarrage à froid dans la prévision de la mode ?
Le problème de démarrage à froid survient chaque fois qu'un détaillant doit prédire la demande pour un produit qui n'a aucune donnée de ventes antérieure. En mode, cela arrive chaque saison : une nouvelle coupe de denim, une nouvelle palette de couleurs, une silhouette inspirée des dernières tendances des défilés. Les méthodes traditionnelles de prévision en séries temporelles s'appuient sur les ventes historiques pour projeter la demande future, elles échouent donc complètement lorsqu'aucun historique n'existe. Les acheteurs s'appuient plutôt sur l'expérience, les recommandations des fournisseurs, les achats tests pré-saison et les tendances macro au niveau des catégories. Ces méthodes sont subjectives, difficiles à mettre à l'échelle et sujettes aux biais.
La prévision par similarité d'attributs reformule le problème. Au lieu de demander ce que cet article exact a vendu dans le passé, le modèle demande quels articles avec des attributs similaires se sont bien vendus, dans quels contextes et à quels segments de clientèle. Si une nouvelle jupe midi en vert forêt n'a jamais été en stock, le système recherche des jupes midi passées dans des tons foncés de pierres précieuses, pondère les performances de vente de ces analogues par le degré de similarité et produit une distribution de prévision. La méthode s'appuie toujours sur les données historiques, mais elle emprunte des modèles à des produits adjacents plutôt que d'exiger une correspondance directe.
Comment fonctionnent les modèles de similarité par attributs dans la pratique ?
Au cœur de chaque modèle de similarité par attributs se trouve une taxonomie de produits : un catalogue structuré de caractéristiques qui décrivent chaque article. Les attributs typiques incluent la famille de couleurs, la silhouette ou la coupe, la composition et le poids du tissu, la longueur des manches, l'encolure, les embellissements, la fourchette de prix, le positionnement de la marque et la saisonnalité. Certains détaillants ajoutent des balises qualitatives telles que le thème de tendance, l'occasion ou la tribu de style. Chaque produit historique du catalogue reçoit un vecteur de valeurs d'attributs, et le même processus de balisage est appliqué à chaque nouveau style avant qu'il n'entre dans l'assortiment.
Une fois les produits encodés sous forme de vecteurs d'attributs, le modèle calcule les scores de similarité. Les techniques varient. Certains systèmes utilisent la similarité cosinus ou la distance euclidienne dans un espace de caractéristiques à haute dimension. D'autres emploient le filtrage collaboratif, traitant les attributs comme des évaluations d'utilisateurs. Les approches plus sophistiquées entraînent des réseaux neuronaux pour apprendre quelles combinaisons d'attributs prédisent des modèles de demande similaires, même lorsque les caractéristiques de surface diffèrent. L'appariement des couleurs repose souvent sur des espaces colorimétriques perceptuels tels que CIELAB plutôt que sur de simples codes hexadécimaux, car deux nuances qui semblent similaires à l'œil humain doivent être traitées comme similaires même si leurs valeurs RVB divergent.
Le modèle récupère ensuite les principaux analogues : les produits historiques ayant les scores de similarité les plus élevés. Il agrège leurs séries temporelles de ventes, pondérant chaque analogue par similarité et récence, et applique des ajustements pour le contexte tels que le mix de canaux, les préférences régionales, le calendrier promotionnel et les tendances macro. Le résultat est une prévision de demande probabiliste, généralement exprimée sous forme de plage ou de distribution plutôt que d'estimation ponctuelle unique. Les merchandisers peuvent utiliser cette prévision pour définir les quantités d'achat initiales, allouer les stocks entre les magasins ou les centres de distribution et planifier les déclencheurs de réapprovisionnement.
- 2015-2018Les premiers adoptants expérimentent l'apprentissage automatique sur les séries temporelles de ventes historiques pour les articles de réapprovisionnement de ba
- 2019-2020Les plateformes cloud intègrent la reconnaissance d'images pour baliser automatiquement les attributs des produits à partir de photographies
- 2021-2022Les méthodes de similarité par attributs gagnent du terrain pour la prévision en démarrage à froid pendant la volatilité de l'approvisionnement liée à la pandém
- 2023Les outils d'IA générative émergent pour synthétiser les descriptions de produits et extraire les attributs de texte non structuré
- 2024-2025Les détaillants testent la détection de la demande en temps réel qui met à jour les prévisions quotidiennement en utilisant les signaux de recherche, de navigat
- 2026La prévision basée sur les attributs devient une pratique courante pour l'introduction de nouveaux produits chez les grands détaillants multimarques
Source: Rapports de l'industrie et divulgations d'entreprises
Quels attributs comptent le plus pour la précision des prévisions ?
Tous les attributs n'ont pas le même poids prédictif. Les études empiriques et l'expérience des praticiens suggèrent que la couleur, la silhouette et le tissu figurent systématiquement parmi les signaux les plus forts, mais leur importance relative varie selon la catégorie et le segment de clientèle. Pour les hauts pour femmes, l'encolure et la longueur des manches comptent souvent plus que le poids du tissu. Pour le denim, la coupe et le lavage sont primordiaux. Pour les vêtements d'extérieur, le type d'isolation et la longueur dominent. Le niveau de prix et le positionnement de la marque jouent également un rôle : un pull en cachemire de luxe et un pull en acrylique de mode rapide peuvent partager la même couleur et silhouette, mais leurs moteurs de demande diffèrent.
L'appariement des couleurs mérite une attention particulière. La similarité perceptuelle des couleurs ne s'aligne pas toujours avec la similarité des ventes. Un blazer marine peut se vendre comme un blazer noir dans les vêtements de travail professionnels, mais une robe de soirée bleu cobalt se comporte différemment d'une robe bleu nuit. Le contexte et la catégorie modulent l'effet. Certains détaillants résolvent cela en regroupant les couleurs en familles telles que les neutres, les vifs, les pastels et les imprimés, puis en affinant au sein de chaque groupe. D'autres utilisent des embeddings d'images provenant de réseaux neuronaux convolutifs, qui apprennent des représentations de couleurs corrélées avec le comportement d'achat plutôt que de s'appuyer sur des palettes prédéfinies.
La saisonnalité et le timing des tendances ajoutent une autre couche. Une doudoune rose millénial lancée à l'automne 2023 n'est pas un analogue parfait pour une doudoune vert sauge lancée à l'automne 2026, même si la construction est identique, car le cycle de tendance plus large a changé. Les modèles avancés incorporent des fonctions de décroissance temporelle qui réduisent le poids des analogues plus anciens, ou ils segmentent les données d'entraînement par saison de mode pour s'assurer que seuls les modèles récents informent la prévision.
Quelles améliorations de précision les détaillants constatent-ils réellement ?
Les études de cas publiées et les affirmations des fournisseurs citent des gains de précision des prévisions allant de 20 à 40 pour cent pour les produits en démarrage à froid, mesurés comme des réductions de l'erreur absolue moyenne en pourcentage ou des augmentations de la valeur ajoutée des prévisions par rapport aux bases de référence naïves telles que les moyennes de catégorie ou les estimations des acheteurs. Traduire la précision en impact commercial dépend du modèle opérationnel du détaillant, de la structure des marges et de la flexibilité de la chaîne d'approvisionnement.
Un exemple concret provient d'une présentation de l'industrie de 2025. Un détaillant de mode multimarques européen a mis en œuvre un système de prévision par similarité d'attributs pour les nouveaux styles saisonniers dans les vêtements pour femmes et pour hommes. L'entreprise a signalé que l'erreur de prévision pour les produits sans historique de ventes a chuté d'environ 30 pour cent au cours de la première saison complète, entraînant une réduction mesurable des taux de démarque de fin de saison et une amélioration de la vente au prix plein. Le détaillant a attribué ce gain à un meilleur alignement entre les quantités d'achat initiales et la demande réelle des clients, en particulier pour les styles de milieu de gamme qui n'étaient ni des best-sellers évidents ni des expériences de niche.
Il est important de distinguer entre la précision des prévisions et les résultats commerciaux. Un modèle peut être statistiquement précis mais ne pas générer de profit si l'organisation n'agit pas sur la prévision, si les délais de livraison sont trop longs pour réagir, ou si l'assortiment de produits lui-même est mal conçu. Inversement, même une modeste amélioration de la précision peut générer une valeur significative dans les catégories à volume élevé et à faible marge où les coûts de détention des stocks et l'exposition aux démarques sont importants.
| Métrique | Prévision traditionnelle de l'acheteur | Modèle de similarité par attributs | Amélioration |
|---|---|---|---|
| Erreur absolue moyenne en pourcentage | 45-60 % | 30-40 % | Réduction de 20 à 40 % |
| Biais de prévision (sur ou sous) | Souvent positif (surachat) | Plus proche de zéro | Stock équilibré |
| Temps pour générer la prévision | Jours à semaines | Minutes à heures | 10 à 100 fois plus rapide |
| Évolutivité (références par saison) | Centaines (limite manuelle) | Dizaines de milliers | Volume élevé faisable |
Quelle infrastructure de données est nécessaire ?
La prévision par similarité d'attributs exige des données produits propres, cohérentes et complètes. Chaque référence doit être balisée avec la même taxonomie, en utilisant des vocabulaires contrôlés plutôt que du texte libre. Les noms de couleurs doivent correspondre à une palette standard. Les descripteurs de coupe tels que slim, regular et relaxed doivent être appliqués uniformément à travers les acheteurs et les saisons. Les compositions de tissus doivent être enregistrées dans un format lisible par machine, et non enfouies dans des descriptions de fournisseurs non structurées. Toute lacune ou incohérence dans le catalogue d'attributs dégrade la capacité du modèle à trouver des analogues valides.
De nombreux détaillants découvrent que leurs systèmes de gestion des informations produits hérités ont été conçus pour la publication de catalogues et la conformité réglementaire, et non pour l'apprentissage automatique. Les attributs sont manquants, dupliqués dans les champs ou saisis de manière incohérente par différentes équipes. La remédiation nécessite à la fois un investissement technologique et un changement de processus. Certaines organisations déploient des modèles de vision par ordinateur pour baliser automatiquement les attributs à partir de photographies de produits, ou du traitement du langage naturel pour extraire des caractéristiques des fiches techniques des fournisseurs. D'autres imposent une gouvernance des données plus stricte, formant les acheteurs et les merchandisers à compléter les formulaires d'attributs au moment de la création du produit.
Les données de ventes historiques doivent également être fiables et suffisamment granulaires. Le modèle doit savoir non seulement qu'un style a vendu 5 000 unités la saison dernière, mais comment la demande a varié par semaine, par groupe de magasins, par canal et par événement promotionnel. Les périodes de rupture de stock doivent être signalées, car les ventes observées sont censurées par la disponibilité des stocks. Les retours et les annulations doivent être suivis séparément des ventes brutes. Idéalement, le détaillant capture également des signaux de quasi-correspondance tels que les requêtes de recherche pour des articles en rupture de stock, les inscriptions sur liste d'attente et les paniers abandonnés, qui révèlent une demande latente qui ne s'est jamais convertie en transaction.
Comment les entreprises intègrent-elles les prévisions de l'IA dans le flux de travail d'achat ?
La technologie seule ne change pas les résultats. La prévision doit être intégrée dans le processus de prise de décision, avec une responsabilité claire et des boucles de rétroaction. Les détaillants leaders traitent la prévision de l'IA comme une entrée parmi plusieurs, et non comme un oracle. Les acheteurs examinent la sortie du modèle aux côtés de leur propre connaissance du marché, de leurs relations avec les fournisseurs et de leur stratégie saisonnière. Lorsque le modèle et l'humain ne sont pas d'accord, l'organisation doit avoir un protocole : l'acheteur a-t-il l'autorité de passer outre, ou le modèle fixe-t-il un plancher et un plafond dans lesquels l'acheteur peut manœuvrer ?
Certaines entreprises adoptent une approche de test et d'apprentissage. Elles permettent au modèle de définir les quantités d'achat pour un sous-ensemble de nouveaux styles, choisis au hasard ou dans des catégories où les performances humaines sont les plus faibles, tandis que les acheteurs conservent le contrôle sur le reste de l'assortiment. Après la saison, l'équipe compare les taux de vente, la marge et la santé des stocks entre les achats pilotés par le modèle et ceux pilotés par l'humain. Cette conception expérimentale renforce la confiance et fait ressortir les cas où le modèle excelle ou échoue.
La rétroaction est critique. Lorsqu'une prévision échoue gravement, l'équipe doit enquêter sur les raisons. La sélection d'analogues était-elle défectueuse ? Un choc externe tel que la météo ou un moment viral sur les réseaux sociaux a-t-il modifié la demande ? La photographie du produit était-elle trompeuse, amenant l'algorithme de balisage à mal classer le style ? Chaque post-mortem alimente l'affinement du modèle et les améliorations de la qualité des données. Au fil du temps, le système apprend de ses erreurs, et l'organisation apprend quels contextes favorisent le jugement algorithmique par rapport au jugement humain.
Quels sont les risques et les limites ?
La prévision par similarité d'attributs fonctionne mieux pour les produits évolutifs : de nouveaux styles qui remixent des éléments familiers dans de nouvelles combinaisons. Elle a du mal avec l'innovation véritablement disruptive. Si un détaillant lance une catégorie qui n'a aucun analogue historique, comme un type de vêtement entièrement nouveau ou une collaboration avec une célébrité dont l'esthétique diffère des archives de la marque, le modèle a peu de points d'ancrage. Dans ces cas, l'intuition humaine, les marchés tests et les campagnes de précommande restent les principaux outils.
Le biais est une autre préoccupation. Si l'assortiment historique était orienté vers certaines données démographiques, niveaux de prix ou esthétiques, le modèle répliquera et potentiellement amplifiera ce biais. Un système entraîné sur des années de palettes de couleurs conservatrices peut sous-estimer la demande pour des teintes audacieuses et expérimentales, décourageant les acheteurs de prendre des risques créatifs. Cela crée une boucle de rétroaction : le modèle recommande des achats prudents, le détaillant stocke moins de produits aventureux, les données de ventes pour les produits aventureux restent rares, et le modèle continue de favoriser les choix sûrs. Briser le cycle nécessite une intervention délibérée, comme la réservation d'une partie de l'assortiment pour des expériences à forte variance exclues de la prévision automatisée.
La confidentialité des données et la dynamique concurrentielle comptent également. Les détaillants qui partagent les données d'attributs et de ventes avec des plateformes tierces accèdent à des benchmarks et à des informations inter-détaillants, mais ils risquent de divulguer des informations exclusives sur la stratégie produit et les préférences des clients. Les fournisseurs et les prestataires de technologies doivent offrir une gouvernance robuste des données, garantissant que les données d'un détaillant n'informent jamais directement la prévision d'un autre. L'examen réglementaire de la prise de décision algorithmique s'intensifie, en particulier dans l'Union européenne, où les exigences de transparence et d'explicabilité peuvent contraindre les détaillants à documenter comment les prévisions sont générées et comment elles influencent les décisions d'inventaire et de tarification.
| Disponibilité des données | Nouveauté du produit | Stabilité de la catégorie | |
|---|---|---|---|
| Articles de réapprovisionnement de base | élevé | faible | élevé |
| Mode saisonnière avec silhouettes familières | élevé | moyen | moyen |
| Mode rapide menée par les tendances | moyen | moyen | faible |
| Nouvelle catégorie ou collaboration de marque | faible | élevé | faible |
| Collections capsules en édition limitée | faible | élevé | faible |
0 = mauvaise adéquation, 3 = excellente adéquation
Source: Synthèse de l'auteur des conseils des praticiens
Questions fréquemment posées
Que doivent faire les entreprises de mode maintenant ?
- Auditez votre taxonomie de données produits. Effectuez un examen systématique de l'exhaustivité, de la cohérence et de la couverture des attributs pour toutes les références. Identifiez les lacunes et normalisez les conventions de dénomination avant de tenter d'entraîner un modèle.
- Commencez par une catégorie. Testez la prévision par similarité d'attributs dans une seule catégorie de produits où vous avez des données historiques riches, des introductions fréquentes de nouveaux produits et des points de douleur mesurables tels que des taux de démarque élevés ou des ruptures de stock. Prouvez la valeur avant de passer à l'échelle.
- Établissez une propriété interfonctionnelle. Attribuez une responsabilité conjointe aux équipes de merchandising, de science des données et d'information produit. La précision des prévisions dépend de la collaboration, et non de la transmission du problème à l'informatique en attendant un tableau de bord.
- Investissez dans l'IA d'image et de texte. Déployez la vision par ordinateur et le traitement du langage naturel pour baliser automatiquement les nouveaux styles au moment de leur création, réduisant la charge de saisie manuelle des données et améliorant la cohérence du balisage. Validez les résultats avec une révision humaine initialement.
- Établissez une gouvernance du modèle. Définissez des règles claires pour le moment où les acheteurs peuvent passer outre les prévisions, comment les écarts sont escaladés, et comment les performances du modèle sont mesurées et rapportées. Assurez la transparence et la responsabilité à chaque étape.
- Réservez un budget pour l'expérimentation. Protégez une partie de votre assortiment de la prévision algorithmique pour tester des styles audacieux à variance élevée qui peuvent ne pas correspondre aux modèles historiques. Utilisez ces expériences pour découvrir de nouveaux signaux de demande et rafraîchir vos données d'entraînement.
- Surveillez les biais et la dérive. Auditez régulièrement les résultats des prévisions pour détecter les biais démographiques, le déséquilibre des niveaux de prix et la stagnation des catégories. Mettez à jour les données d'entraînement, repondérez les analogues et ajustez les métriques de similarité pour contrer les biais et vous adapter aux préférences changeantes des clients.
Questions fréquentes
La prévision par similarité d'attributs peut-elle remplacer les acheteurs humains ?
Non. Les modèles fournissent des prévisions de demande, mais les acheteurs prennent toujours des décisions stratégiques sur la composition de l'assortiment, la négociation avec les fournisseurs, le positionnement de la marque et l'orientation créative. La technologie augmente le jugement humain plutôt que de le remplacer, en particulier pour les styles véritablement nouveaux ou disruptifs.
Combien de temps faut-il pour mettre en œuvre un système de prévision basé sur les attributs ?
Les délais de mise en œuvre varient considérablement en fonction de la maturité des données. Les détaillants disposant de taxonomies de produits propres et de bases de données de ventes historiques robustes peuvent déployer des pilotes en trois à six mois. Ceux nécessitant une remédiation extensive des données peuvent avoir besoin de 12 à 18 mois avant d'obtenir des prévisions fiables à grande échelle.
Quelle est la quantité minimale de données historiques nécessaire ?
La plupart des praticiens recommandent au moins deux à trois ans d'historique de ventes couvrant plusieurs cycles saisonniers et quelques milliers de références distinctes par catégorie. Les ensembles de données clairsemés produisent des analogues peu fiables et une variance élevée des prévisions, limitant la valeur pratique du modèle.
Sources
- McKinsey & Company: The state of fashion technology 2025
- Vogue Business: AI and machine learning in fashion forecasting 2025
- Reuters: Fashion retailers adopt AI for inventory management 2025
- Retail Dive: Demand forecasting technology trends 2026
- FashionUnited: How AI is solving the cold start problem in fashion 2025