Digitalizzare l'archivio di un brand per l'IA: scansione, tagging e diritti
Come trasformare capi, tessuti e documenti in un archivio ricercabile e utilizzabile, e quali questioni di diritti chiarire prima di addestrare o interrogare qualsiasi sistema su di esso.
IN SINTESI Sintesi della redazione
- Una rassegna del 2025 di ricercatori del Politecnico di Milano raggruppa gli elementi d'archivio in cinque categorie: capi e accessori, tessuti e campioni, documenti tecnici e di produzione, materiali visivi e promozionali, registri storici e aziendali.
- L'IA può aiutare con metadati, restauro e ricostruzione 3D, ma la rassegna osserva che molti archivi sono digitalizzati solo in parte e che i loro metadati sono spesso incompleti o incoerenti.
- L'esempio della Virginia Tech nella rassegna ha usato i word embedding per generare metadati descrittivi aggiuntivi per una collezione di costumi e tessuti, con una persona nel ciclo di controllo.
- La rassegna segnala diritto d'autore, titolarità dei dati e proprietà intellettuale come motivi di preoccupazione quando i contenuti d'archivio servono ad addestrare modelli generativi personalizzati.
- Secondo le linee guida del Copyright Office statunitense, il risultato di un modello addestrato su un archivio è proteggibile solo per il suo contributo umano, quindi un archivio da solo non rende i design generati di propria titolarità.
Digitalizzare l'archivio di un brand per l'IA significa acquisire ogni elemento a una qualità uniforme, descriverlo con un vocabolario controllato, registrare chi detiene i diritti su ciascun elemento e solo dopo decidere come l'IA possa usarlo. La scansione è la parte facile. Gran parte del valore duraturo, e gran parte del rischio, sta nei metadati e nel registro dei diritti.
Che cosa contiene un archivio di moda?
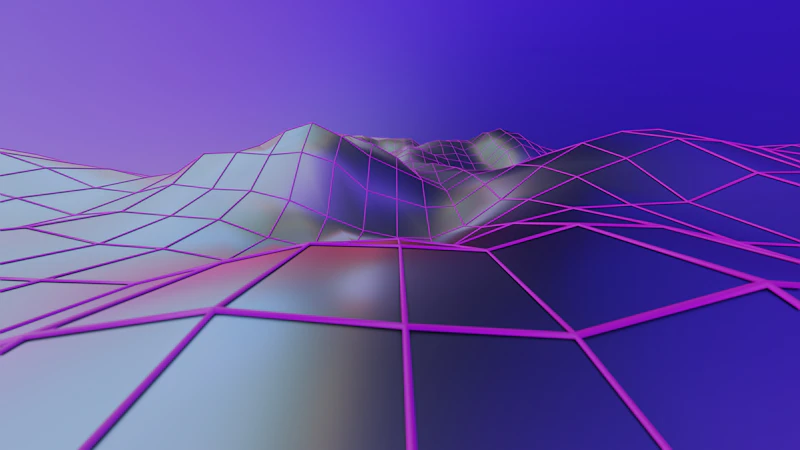
Una rassegna integrativa del 2025 di Greta Rizzi e Daria Casciani del Politecnico di Milano, pubblicata sull'European Journal of Cultural Management and Policy, individua cinque categorie di elementi d'archivio. Sono capi e accessori, tessuti e campioni di stoffa, documenti tecnici e di produzione, materiali visivi e promozionali, registri storici e aziendali. Ciascuna richiede un diverso metodo di acquisizione e comporta diritti diversi. Un disegno tecnico realizzato da un dipendente, una fotografia di un fotografo freelance e una stampa su licenza sono tre diverse situazioni di titolarità.
La rassegna avverte inoltre che molti archivi sono digitalizzati solo in parte e che i metadati sono spesso incompleti o incoerenti. Per l'IA conta, perché un modello o un sistema di ricerca vale quanto le descrizioni e i collegamenti che riesce a leggere.
Come si scansionano e si acquisiscono gli elementi d'archivio?
Le scelte di acquisizione dipendono dall'oggetto. Gli elementi piani, come schizzi, campioni e materiale stampato, si prestano alla scansione piana ad alta risoluzione con target di riferimento colore. I capi richiedono fotografia standardizzata e, talvolta, acquisizione 3D. La rassegna del Politecnico di Milano osserva che la scansione 3D dei tessuti ha dei limiti, come la resa dei dettagli fini della superficie e la gestione della riflettività variabile, e suggerisce che l'IA possa aiutare a colmare lacune e correggere errori di scansione. Ogni immagine riparata dall'IA va trattata come derivato, conservando l'originale intatto.
- Usare risoluzione, profilo colore e formato di file uniformi per ciascun tipo di elemento.
- Includere un riferimento di colore e di scala in ogni acquisizione.
- Conservare i master originali separati dalle copie di lavoro e dalle versioni restaurate con l'IA.
- Assegnare a ogni elemento un identificativo persistente che colleghi immagini, schede e dati sui diritti.
Come può l'IA aiutare a etichettare e catalogare un archivio?
La rassegna descrive diversi esempi. Il dipartimento di Fashion Merchandising and Design della Virginia Tech ha usato i word embedding per generare metadati descrittivi aggiuntivi per la Oris Glisson Historic Costume and Textile Collection, con un approccio human-in-the-loop. Il progetto SILKNOW ha combinato reti neurali, grafi di conoscenza ed elaborazione del linguaggio naturale per migliorare la ricerca e standardizzare i dati multilingue sul patrimonio serico. Un progetto chiamato FabricNet applica reti neurali convoluzionali per riconoscere i tipi di fibra tessile a partire da immagini della superficie.
Lo schema ricorrente è che il modello propone e uno specialista conferma. Un modello può suggerire che una fotografia mostri un cappotto di lana doppiopetto, ma un curatore conosce la stagione, l'atelier e sa se il capo è una replica. Conviene integrare la revisione nel processo e registrare se ogni tag sia stato inserito da una persona, proposto da un modello o confermato da una persona.
Quali questioni di diritti vanno chiarite per prime?
La rassegna indica diritto d'autore, titolarità dei dati e proprietà intellettuale come motivi di preoccupazione, soprattutto quando i contenuti d'archivio servono ad addestrare modelli generativi personalizzati. Solleva anche questioni di paternità e di agency creativa. Prima che un archivio alimenti qualsiasi strumento generativo, conviene costruire un registro dei diritti che risponda alle domande seguenti per ogni elemento o gruppo di elementi.
| Campo | Domanda a cui rispondere | Perché conta |
|---|---|---|
| Autore | Dipendente, freelance, agenzia o sconosciuto? | Determina chi detiene il diritto d'autore e se la cessione è documentata |
| Contenuti di terzi | L'elemento include stampe, fotografie o loghi su licenza? | Le licenze possono non consentire l'addestramento di IA o l'uso derivato |
| Durata e territorio | La licenza è ancora valida e dove? | Il riutilizzo dell'archivio spesso sopravvive alle licenze originarie |
| Dati personali | Le immagini mostrano persone identificabili? | Si applicano i requisiti di privacy e consenso |
| Uso di IA consentito | Solo ricerca, fine-tuning interno o strumenti esterni? | Limita ciò che può uscire dall'azienda |
| Provenienza dei tag | Umana, proposta dal modello o confermata? | Supporta controllo qualità e audit |
Si può addestrare un modello sul proprio archivio?
Alcune aziende ci hanno provato. La rassegna del Politecnico di Milano elenca esempi tra cui AI ARCHIVE di Adidas, un modello di diffusione addestrato su immagini di sneaker, e un sistema generativo addestrato da Norma Kamali con Maison Meta su 57 anni di immagini del marchio, oltre a Burberry e Lanvin che hanno usato l'animazione con IA di immagini d'archivio. La rassegna si basa su rapporti aziendali e letteratura grigia e riconosce che ciò può introdurre una distorsione ottimistica verso i risultati tecnologici, per cui non va letta come prova di risultati commerciali.
Addestrare o rifinire un modello su un archivio di proprietà non elimina le altre questioni. I risultati che somigliano a pezzi d'archivio possono essere molto vicini agli originali e il rapporto del Copyright Office statunitense del gennaio 2025 afferma che il risultato dell'IA è proteggibile solo per il contributo di paternità umana. Un modello addestrato sull'archivio può ispirare nuovo lavoro, ma non rende il risultato automaticamente di propria titolarità né esente da rischi di somiglianza.
Come si presenta un'introduzione sensata?
- Fare l'inventario dell'archivio secondo le cinque categorie e stimare quale quota sia digitalizzata.
- Avviare un pilota su una collezione ben conosciuta, come una singola stagione o linea di prodotto.
- Definire un vocabolario controllato e un modello di tagging prima di avviare qualsiasi tagging con l'IA.
- Costruire il registro dei diritti per la collezione pilota e contrassegnare gli elementi autorizzati per ciascun livello di uso dell'IA.
- Eseguire il tagging con l'IA con conferma umana e misurare quanto spesso i curatori lo correggono.
- Decidere se un uso generativo sia giustificato e mantenere i risultati etichettati e registrati.
Budget e competenze sono un ulteriore vincolo. La rassegna elenca tra le preoccupazioni economiche i budget e le competenze limitati di molte istituzioni, insieme a una possibile concentrazione del mercato e alla marginalizzazione delle organizzazioni più piccole. Un brand con un archivio modesto può comunque fare progressi partendo dai pezzi più preziosi e meglio documentati, anziché puntare a una copertura completa prima che un beneficio diventi visibile.
Domande frequenti
Come si digitalizza un archivio di moda?
Acquisendo gli elementi piani con scansione ad alta risoluzione e riferimento colore, fotografando i capi in modo uniforme e valutando l'acquisizione 3D dove utile. Assegnare a ogni elemento un identificativo persistente, conservare i master intatti e collegare ogni scheda a un registro dei diritti.
L'IA può etichettare automaticamente le immagini di un archivio di moda?
Sì, come prima passata. Tra gli esempi di una rassegna del 2025 del Politecnico di Milano figurano metadati basati su word embedding per una collezione storica di costumi e reti neurali per i dati sul patrimonio serico, in entrambi i casi con revisione umana. La conferma di uno specialista resta necessaria per date, autori e contesto.
Posso addestrare un modello di IA sull'archivio del mio brand?
Tecnicamente sì, e alcuni brand ci hanno provato. Occorre prima confermare titolarità e licenze di ogni elemento, verificare i dati personali e decidere chi può usare il modello. I risultati richiedono comunque controlli di somiglianza e negli Stati Uniti la protezione del diritto d'autore si applica solo ai contributi di paternità umana.
Quali sono i principali rischi della digitalizzazione dell'archivio per l'IA?
La rassegna del 2025 elenca diritto d'autore e titolarità dei dati, bias e omogeneizzazione estetica, metadati incompleti o incoerenti e budget e competenze limitati. La scarsa qualità dei metadati è l'ostacolo pratico più comune.
Un'edizione ogni giorno feriale. Si legge in cinque minuti. Gratuita per i professionisti del settore.
FONTI
- Rizzi and Casciani: Scouting emerging AI applications in fashion heritage and archival practices (European Journal of Cultural Management and Policy)
- US Copyright Office: Copyright and Artificial Intelligence, Part 2: Copyrightability
- Chauvin et al.: Weaving the Future: Generative AI and the Reimagining of Fashion Design (arXiv)